

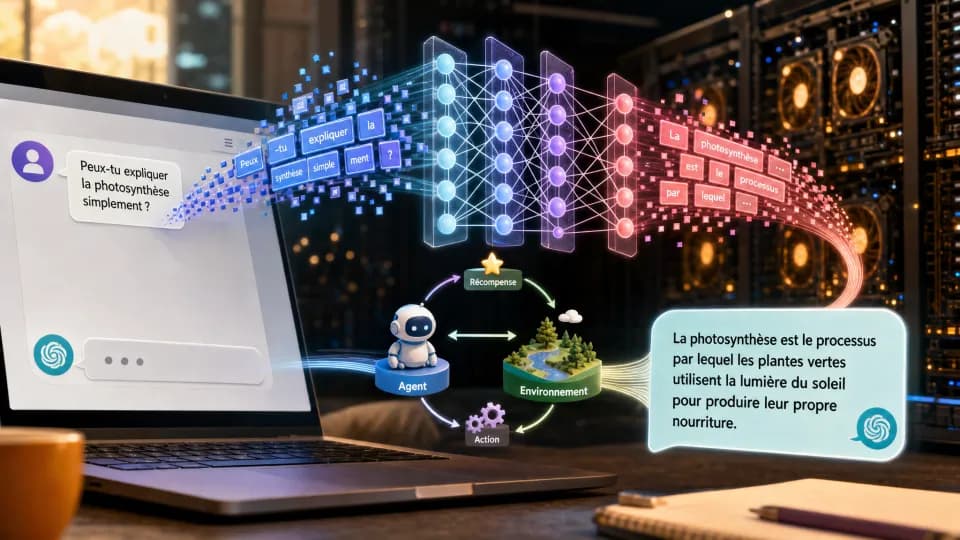
Un Français sur deux dialogue déjà avec une IA générative, sans savoir ce qui se cache derrière. Il ne s'agit pourtant que de mathématiques simples, poussées à une échelle gigantesque.
Les interactions avec les moteurs d'IA générative sont de plus en plus nombreuses : près d'un Français sur deux déclare déjà y avoir recours (source : Crédoc, Baromètre du numérique 2026). Pourtant, rares sont ceux qui réalisent que cette conversation n'est que le résultat d'un calcul mathématique, devenu, au fil du temps, d'une complexité vertigineuse. Comment de simples calculs, mis à l'échelle, finissent-ils par répondre à nos questions ?
Les tokens pour représenter un texte
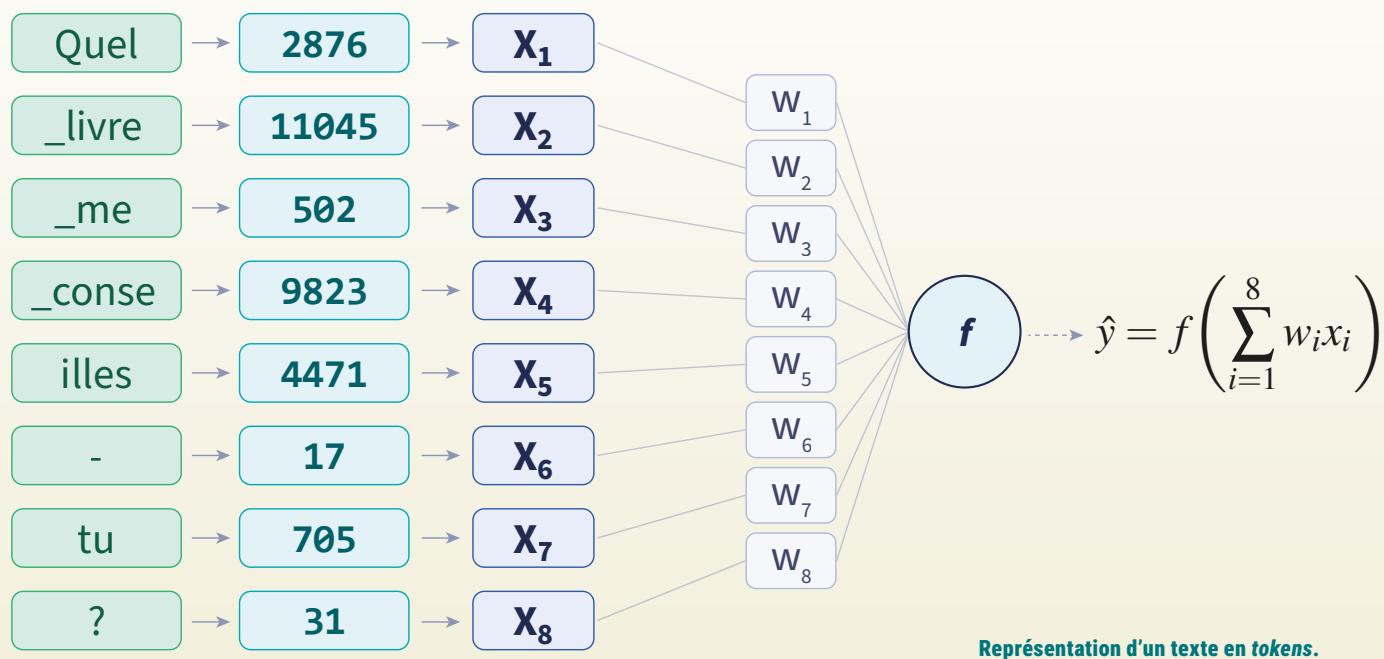
La toute première étape est invisible pour l'utilisateur, mais fondamentale : un modèle mathématique ne voit pas de texte, il ne manipule que des nombres. Avant tout calcul, il faut donc traduire notre question en chiffres. On la découpe en tokens (ou « jetons textuels »), de courtes séquences de caractères, auxquels on associe un identifiant numérique. L'ensemble de ces identifiants forme le dictionnaire des tokens. En théorie, on pourrait y placer un token par caractère pour représenter toutes les langues ; en pratique, ce serait trop coûteux. L'algorithme BPE (Byte Pair Encoding) résout ce compromis en sélectionnant les séquences de caractères les plus fréquentes du corpus. En utilisant le dictionnaire des tokens du modèle le plus connu (ChatGPT), notre question est représentée par huit tokens. Comme les corpus de texte utilisés sont massivement anglophones, le dictionnaire est optimisé pour l'anglais : un modèle « parle » donc plus efficacement dans cette langue qu'en français, où il lui faut souvent plus de tokens pour dire la même chose.