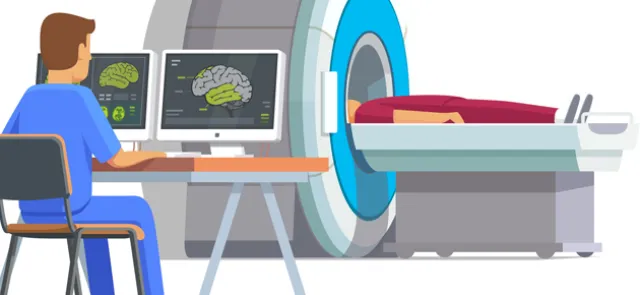
Quelle est la taille de cette tumeur rénale ? Où est située cette petite structure cérébrale, que je souhaite cibler pour mon intervention chirurgicale ? Le stent que j’ai posé dans l’artère est-il correctement positionné ? Pour ces questions, et pour tant d’autres, il est nécessaire de pouvoir fournir au médecin un moyen de localiser un organe ou un objet, lui permettant de le localiser, de le mesurer, ou de quantifier son activité. Les problèmes sous-jacents relèvent de la segmentation d’images, l’un des problèmes les plus intéressants et les plus difficiles à résoudre dans le domaine de la vision par ordinateur.
Identifier des régions
----------------------
La segmentation consiste à identifier et définir des objets présents dans une image : celle-ci n’est plus une collection de pixels (en 2D) ou voxels (en 3D) juxtaposés, mais un ensemble de régions disjointes. Idéalement, les régions ont une signification (objet, structure, signal… ou fond) en dehors de leurs propres caractéristiques picturales (niveaux de gris, forme). Pour identifier les régions dans une image, on distingue deux groupes de méthodes :
• L’approche région : on regroupe les pixels présentant une caractéristique commune, dérivée par exemple de l’intensité des pixels ; le critère est évalué en absolu (amplitudes) ou en relatif (dénivelés) ; on se donne alors des règles de décision, qui sont des seuils définissant des intervalles de valeurs ; les pixels de valeurs comprises entre les seuils et connectés les uns aux autres (on parle de pixels connexes) forment une même région ;
• l’approche contour : on met en place des frontières aux positions qui rendent localement maximale la variation d’un critère ; un contour est une courbe ou une surface (cas des images 3D) fermée et d’épaisseur 1 pixel.