La ricostruzione, da parte del nostro cervello, di rappresentazioni 3D a partire da due immagini quasi identiche presentate ciascuna a uno dei nostri occhi è nota dalla seconda metà del 19º secolo. Gli stereogrammi dell’epoca (costituiti da immagini doppie, vedi l’articolo « La télévision 3D : la télé de demain ? ») si ottenevano con apparecchi fotografici dotati di due obiettivi, la cui distanza corrispondeva a quella fra i nostri occhi (da 6 a 7 cm). Un semplice sistema ottico (lo stereoscopio) permetteva poi di osservare le fotografie doppie e ritrovare la sensazione di rilievo. È la tecnica impiegata nei View-Master da oltre mezzo secolo e ancora oggi usata dai nostri bambini, o dai nostri televisori quando riproducono Blu-ray detti 3D.
In tutti questi casi, l’illusione del rilievo richiede il ricorso a un intermediario (occhiali o stereoscopio). L’idea alla base della costruzione degli autostereogrammi è riuscire a ricreare l’illusione del rilievo senza alcun intermediario: una vera sfida. Certo, ciascuno di noi è naturalmente capace di vedere in rilievo (salvo particolari handicap). Ma scoprire la magia degli autostereogrammi richiede un vero apprendistato, presto ricompensato per alcuni di noi (non per tutti, ahimè!) dalla scoperta di effetti nascosti e sorprendenti. Questo apprendistato può essere facilitato da una serie di trucchi e metodi, che giocano in particolare con punti di convergenza o mezzi ottici (mirino 3D, prismi, anamorfosi, uso di LED). Il campo delle possibilità offerte da questo tipo d’immagini è immenso; stupisce vederle così poco presenti nelle applicazioni. Perché, infatti, non immaginare un ambiente in cui griglie, paraventi, claustra (pareti traforate), carte da parati integrino questo tipo d’illusione, inventando così un design 3D ludico del tutto nuovo?
Un nuovo design 3D ludico
----------------------------
Percepiamo naturalmente la profondità e il rilievo. I nostri occhi si orientano verso uno stesso punto, mettono a fuoco e trasmettono al cervello due immagini che la nostra corteccia visiva interpreta. Basta scegliere: nell’esempio qui accanto, si può decidere di vedere la torre dell’acqua oppure la griglia. È impossibile vedere nitidamente entrambi i piani nello stesso momento.
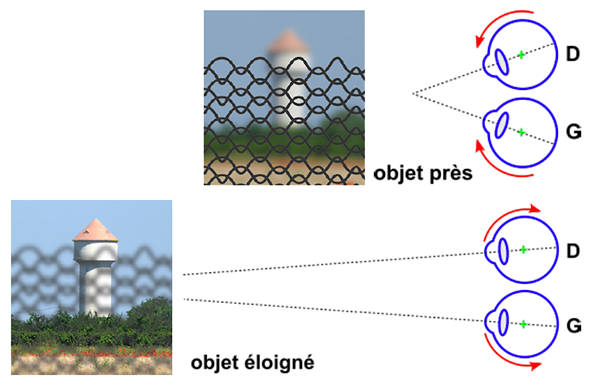
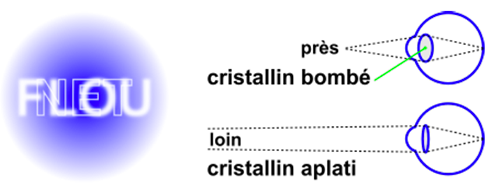
I nostri occhi si orientano dunque simultaneamente verso l’oggetto scelto. Più è vicino, più gli occhi convergono: è la convergenza. Poi effettuano la messa a fuoco: il cristallino di ciascun occhio si deforma per ottenere una visione nitida. Più l’oggetto è vicino, più il cristallino è convesso: è l’accomodazione. Il nostro cervello riceve e confronta due immagini leggermente diverse.
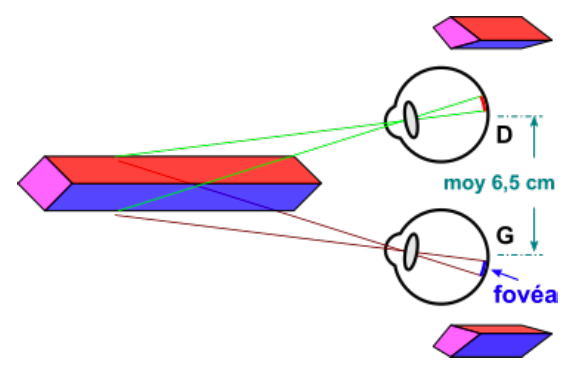
Più l’oggetto è vicino, più le immagini sono diverse: è la disparità binoculare. Dopo aver interpretato l’informazione ricevuta, il nostro cervello ci restituisce un’impressione di volume.
Un’immagine piana che offre il 3D non consente di rispettare questi principi fisiologici, poiché la convergenza dei nostri occhi e l’accomodazione non avvengono sullo stesso piano. «Vedere in 3D» richiede quindi uno sforzo da parte dell’osservatore. Per alcuni la visione volumetrica sarà facile, per altri più difficile. Per altri ancora sarà addirittura impossibile senza aiuto.
La sfida consiste dunque nell’indurre i nostri occhi a fissare un punto esterno all’immagine senza accomodarsi su di essa. La disparità binoculare richiede di usare una coppia d’immagini stereoscopiche oppure un autostereogramma, che il cervello analizzerà. La convergenza ci porta a fissare con entrambi gli occhi un punto posto davanti (AV) o dietro (AR) l’immagine, affinché il cervello sovrapponga i moduli destro e sinistro fondendoli in un’unica immagine. Esiste infatti una relazione fra le distanze occhio–punto AV–punto AR–passo dell’immagine. Infine, l’accomodazione richiede di lasciare qualche secondo al nostro apparato visivo per correggere lo sdoppiamento dell’immagine e ottenerne una nitida.
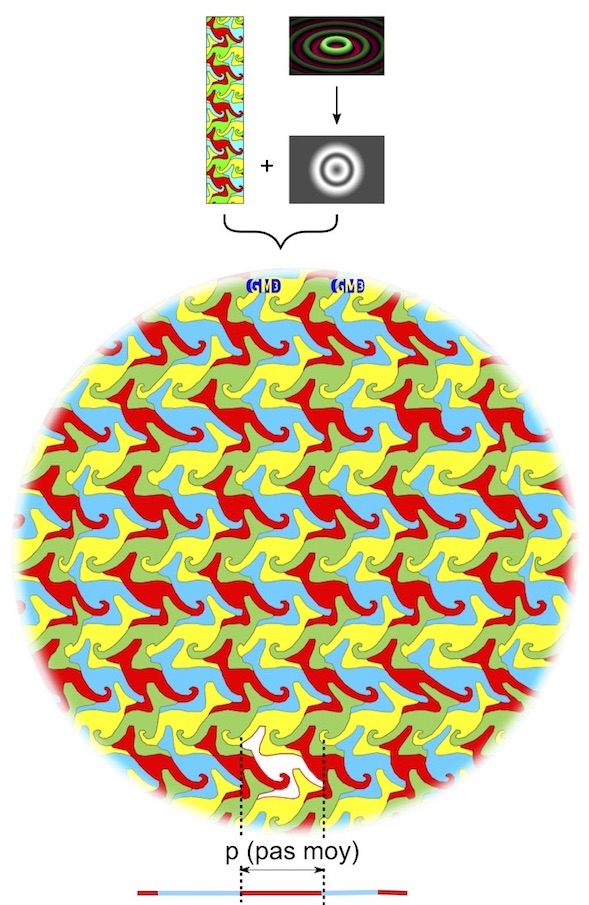
####
Costruzione di un autostereogramma.
Per ricreare l’illusione del rilievo, un autostereogramma sarà costituito da una sola immagine, è vero, ma generalmente composta mediante la ripetizione orizzontale di uno stesso motivo modificato. La variazione della distanza fra ciascun punto equivalente dei motivi permette allora al cervello di rilevare il volume nascosto. Una grandezza significativa è dunque il passo dell’autostereogramma, ossia la distanza fra due motivi equivalenti ripetuti. Nella trama dei canguri qui accanto, il passo corrisponde alla larghezza di un canguro. Il volume nascosto (sta al lettore scoprirlo grazie a quanto segue!) ha la forma di un’onda o di uno spremilimoni, concavo o convesso a seconda di come lo si guarda. Scaricare la tassellazione del Canguro e le istruzioni per l’uso.
Una questione di convergenza
---------------------------
Per vedere l’immagine stereoscopica in 3D, i nostri occhi devono convergere verso uno stesso punto, posto dietro oppure davanti all’immagine, affinché il nostro cervello le fonda in un’unica immagine. Questa convergenza può essere espressa geometricamente mediante l’angolo formato da due segmenti che partono dall’occhio sinistro (Og) e dall’occhio destro (Od) e si incontrano in un dato punto di convergenza (PdC), posto davanti o dietro.
Per ottenere il 3D, questi due segmenti devono necessariamente coincidere con il passo p della coppia stereoscopica. Nella visione posteriore, l’occhio sinistro deve guardare l’immagine sinistra e l’occhio destro quella destra. Questa situazione è detta visione parallela. Nella visione anteriore, l’occhio sinistro guarda l’immagine destra e l’occhio destro quella sinistra: è la visione incrociata. Queste denominazioni possono apparire fuorvianti; perciò si preferiscono spesso le espressioni visione convergente in AV e visione convergente in AR. Il cambiamento di modalità di visione inverte il verso del volume: una «cavità» diventa una «sporgenza» e viceversa.
Dove ritroviamo il teorema di Talete
------------------------------------------
Poiché l’immagine stereoscopica deve essere parallela al piano degli occhi, il teorema di Talete si applica al triangolo formato dai punti Og, PdC e Od. Esso fornisce allora una relazione fra i dati seguenti:
\- La distanza d fra gli occhi dell’osservatore, variabile da circa 6 a 7 cm secondo la morfologia e l’età delle persone, con un valore medio approssimativamente pari a 6,5 cm;
\- Il segmento p che definisce il «passo medio» dell’immagine e che si può approssimare con (passomaxi + passomini ) / 2, poiché questo passo varia nell’immagine. Altrimenti si avrebbe una semplice immagine a motivi regolari, dunque priva di effetto 3D. Maggiore è la differenza fra i passi, maggiore sarà la profondità;
\- La distanza a fra uno dei nostri occhi e il piano verticale dell’immagine;
\- La distanza b fra l’immagine e il punto di convergenza PdC;
\- La distanza c fra uno dei nostri occhi e il punto di convergenza, con un limite fisiologico inferiore che dipende da ciascuno di noi e al di sotto del quale è difficile vedere nitidamente (in media, 25 cm).
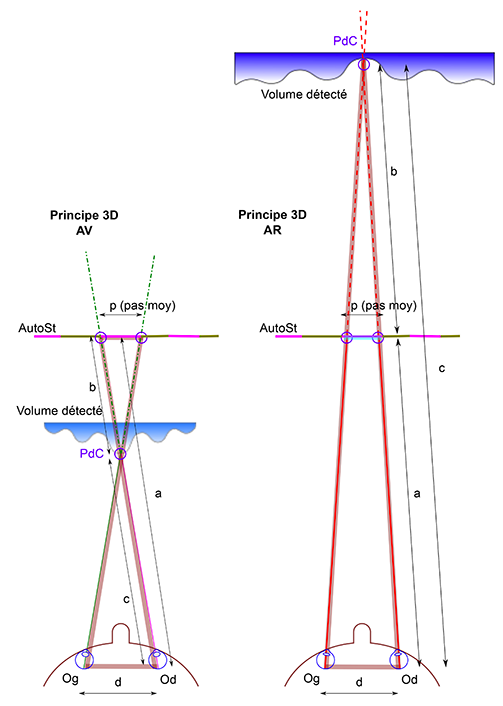
Ciò che si cerca soprattutto è la rapida comparsa dell’effetto 3D. È quindi preferibile concentrarsi sul centro dell’immagine. In questo caso, si può ritenere che le distanze a, b e c «non varino troppo», qualunque sia l’occhio.
Immaginiamo ora due viste stereo S–D, che avviciniamo l’una all’altra (il passo p diminuisce) finché non si sovrappongono (p = 0), poi si incrociano e continuano ad allontanarsi, trasformandosi in una coppia D–S. Il passaggio dal passo positivo a quello negativo (inversione delle immagini S e D) esprime perfettamente l’inversione del volume 3D.
Matematicamente, le relazioni fra queste diverse grandezze si esprimono secondo lo schema precedente. Nella visione posteriore, il teorema di Talete (vedi Tangente 167, 2015) fornisce:
Questa relazione implica ad = cd – cp, ossia
Indichiamo con K3D questo rapporto espresso in %. Si sa che K3D > 100% poiché c > a. Ne segue che, per una data persona, il rapporto K3D sarà direttamente legato al passo medio p dell’immagine.
Un ragionamento identico può naturalmente essere svolto per la visione posteriore, con la relazione:
che questa volta implica
Manteniamo questo rapporto K3D in %, che permette di fissare facilmente un ordine di grandezza della posizione del punto di convergenza rispetto alla distanza occhio–immagine. Nella visione posteriore, si ha c > a, dunque K3D > 100%. Nella visione anteriore, poiché c < a, si ha K3D < 100%. Così, per un osservatore con una distanza fra gli occhi di 6,5 cm, che guarda un’immagine posta a 40 cm da lui con un passo medio di 3,25 cm, si calcola che nella visione AR si ha:
K3D (in %) = d / (d – p) = 6,5 /(6,5 – 3,25) = 200%.
Per un’immagine posta a 40 cm da lui, dovrà far convergere lo sguardo a una distanza pari a:
c = a K3D = 40 × 2/100 = 80 cm.
Nella visione AV, si verifica che K3D (in %) è uguale a d/(d + p), ossia 6,5/(6,5 + 3,25), cioè 67%. Sempre per un’immagine posta a 40 cm da lui, l’osservatore dovrà far convergere lo sguardo a una distanza c pari a a K3D, ossia 40 × 67/100, cioè 26,6 cm.
Autostereogrammi austeri
--------------------------
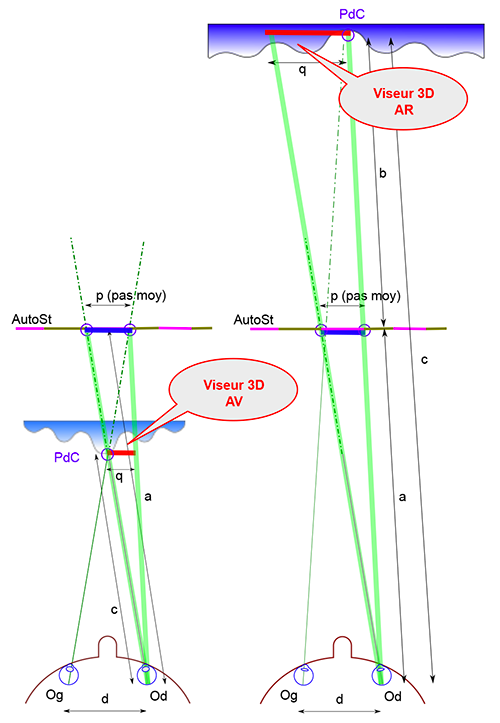
I calcoli sono dunque fatti. Ma ciò non implica affatto che siamo capaci di individuare il punto di convergenza di un autostereogramma senza ricorrere a una calcolatrice, a una tabella o a un doppio decimetro. Torniamo allora al nostro 3D, dimenticando momentaneamente il secondo occhio. Occorre infatti determinare quale larghezza q dovrebbe avere uno schermo posto alla distanza c da un occhio, affinché coincida esattamente con l’angolo tangente al passo p dell’autostereogramma (posto a una distanza a dall’occhio). Il teorema di Talete si applica anche a questa configurazione.
Occorre calcolare a quale distanza b collocare il bastone (di altezza h) affinché si allinei molto precisamente con l’ombra della piramide (di altezza H).
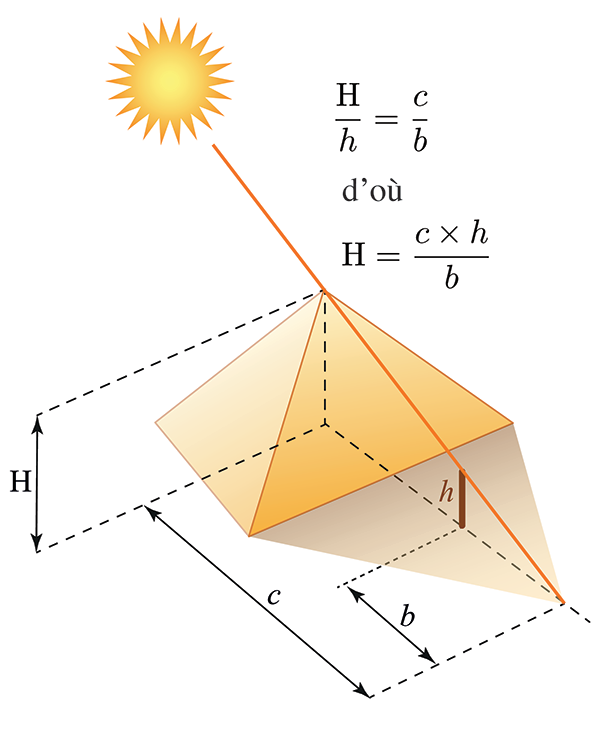
Teorema di Talete
Nella visione posteriore, si verifica che
e dunque
Dai risultati precedenti si ottiene
Simmetricamente, nella visione anteriore si ottiene
Consideriamo un osservatore con una distanza interpupillare di 6,5 cm, che guarda un’immagine con passo di 3,25 cm posta a 40 cm di distanza. Nella visione posteriore si calcola q = 6,5 cm × 3,25 / (6,5 – 3,25) = 6,5 cm.
Nella visione anteriore, il risultato cercato diventa q = 6,5 cm × 3,25 / (6,5 + 3,25) = 2,2 cm. Si osserva che la larghezza q (il passo proiettato) è direttamente legata al passo dell’immagine. Questa relazione può essere rappresentata graficamente mediante un «visore 3D» universale (una sorta di iperbole incrociata), che consente di ricavare direttamente la larghezza q in ascissa a partire da un passo medio letto in ordinata.
La rappresentazione qui sotto illustra i due casi (anteriore AV e posteriore AR).
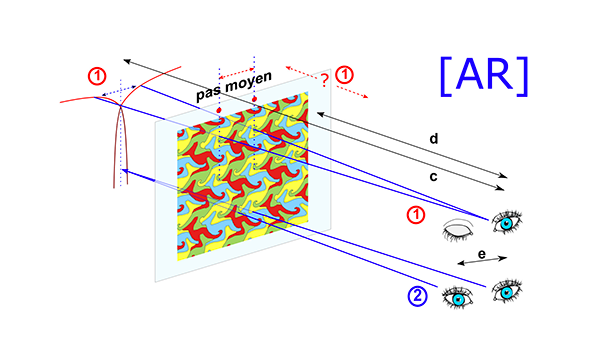
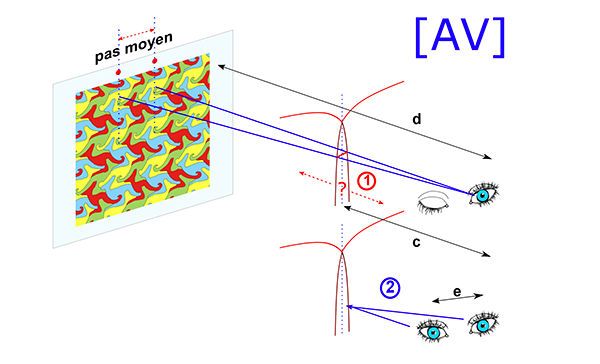
Quali sono le prospettive di questo tipo di immagini? La visione posteriore è limitata dalla distanza tra gli occhi e non permette di immaginare immagini «grandi» (oltre un metro di larghezza, ossia sedici ripetizioni di un passo massimo di 6 cm). La visione anteriore, invece, non ha questo limite, ma è meno diffusa.
Il visore 3D, oppure la visualizzazione del punto di convergenza nel dispositivo, permetterebbero nuove applicazioni. Un ultimo consiglio per cogliere meglio la 3D: scegliete un ambiente luminoso, per avere contrasti migliori, e orientate l’immagine in modo da ottenere un’illuminazione uniforme, possibilmente senza ombre né effetti indesiderati. Ora tocca al lettore esercitarsi!
Dopo la teoria, la pratica!
-------------------------------
Il muro di mattoni paradossale è un modello da piegare seguendo le istruzioni da scaricare. Questo esempio mostra che il cervello può essere ingannato interpretando il volume apparente al contrario.
A seconda di come la si guarda, la molla paradossale può apparire come una figura 3D o una figura impossibile .
Una griglia in rilievo da osservare.