Sea cual sea el ámbito al que se enfrenten, las profesionales y los profesionales de la estadística suelen tratar de encontrar regularidades, semejanzas entre los individuos estudiados, para simplificar una población creando grupos homogéneos en su seno: grupos de consumidores con comportamientos similares en marketing, clasificación de imágenes o de zonas de imágenes médicas, detección de temas en un gran corpus de artículos de prensa…
Es posible partir directamente de la descripción de los datos para encontrar los individuos «más semejantes» (véase, por ejemplo, el método de las K-medias en el artículo «La clasificación automática»). Pero también es posible analizar los datos mediante un modelo estadístico (véase el recuadro), que tiene en cuenta que una población observada procede en realidad de varias subpoblaciones distintas que se han mezclado: es el modelo de mezcla.
Modelización y clustering
----------------------------
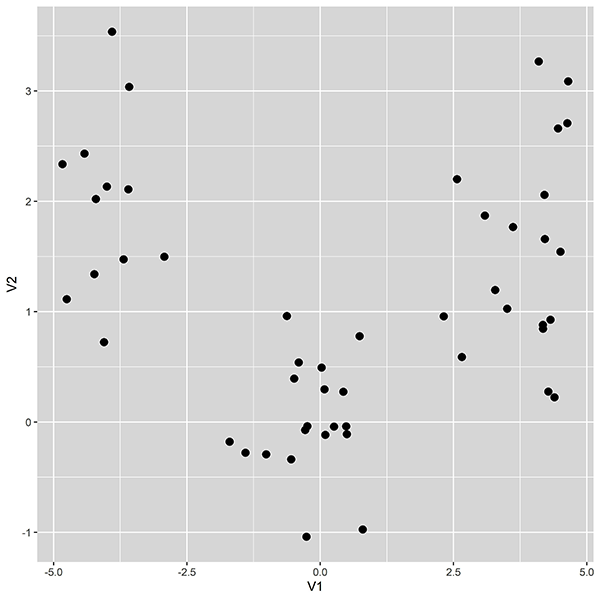
Observemos los datos de la figura siguiente. Si los individuos representados por los puntos se han elegido al azar de una población, estos datos definen una muestra de n observaciones independientes e idénticamente distribuidas en dos dimensiones (por ejemplo, la edad y los ingresos) x1 ∈ ℝ2, *x 2 ∈ ℝ2… *xn* ∈ ℝ2.