Qualunque sia l’ambito in cui operano, le statistiche e gli statistici cercano spesso di individuare regolarità e somiglianze tra gli individui studiati, per semplificare una popolazione creando al suo interno gruppi omogenei: gruppi di consumatori dal comportamento simile nel marketing, classificazione di immagini o di loro zone nell’imaging medico, individuazione di temi in un vasto corpus di articoli di giornale…
Si può partire direttamente dalla descrizione dei dati per individuare gli individui «più simili» (si veda, per esempio, il metodo delle K-medie nell’articolo «La classificazione automatica»). Ma è anche possibile analizzare i dati attraverso un modello statistico (vedi riquadro), che tiene conto del fatto che una popolazione osservata proviene in realtà da più sottopopolazioni diverse mescolate tra loro: è il modello di miscela.
Modellizzazione e clustering
----------------------------
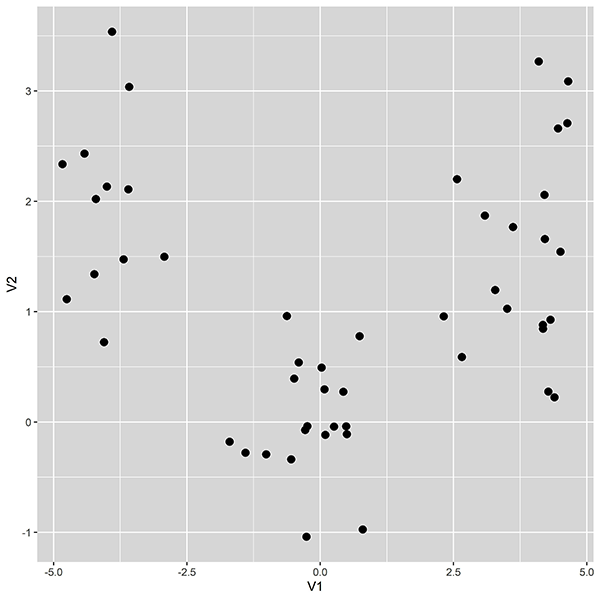
Osserviamo i dati della figura seguente. Se gli individui rappresentati dai punti sono stati scelti a caso in una popolazione, questi dati costituiscono un campione indipendente e identicamente distribuito di n osservazioni in due dimensioni (per esempio, età e reddito) x1 ∈ ℝ2, *x 2 ∈ ℝ2… *xn* ∈ ℝ2.