Post hoc, ergo propter hoc. Avec une concision toute latine, cet aphorisme signifie « après cela, donc à cause de cela ». Soit « ce qui s’est passé a été causé par ce qui l’a précédé ». Ce qui est faux : vous pouvez très bien être couvert de boutons après avoir mangé des amandes sans qu’il y ait un rapport de cause à effet ! Mais si à chaque fois que vous mangez des amandes vous réagissez ainsi, on est en droit de voir dans l’ingestion de certains fruits à coque la cause de votre urticaire : vous êtes allergique. Il n’en est néanmoins pas toujours ainsi : deux évènements peuvent être corrélés sans que le premier qui arrive soit cause du suivant.
Le hasard et les coïncidences
=============================
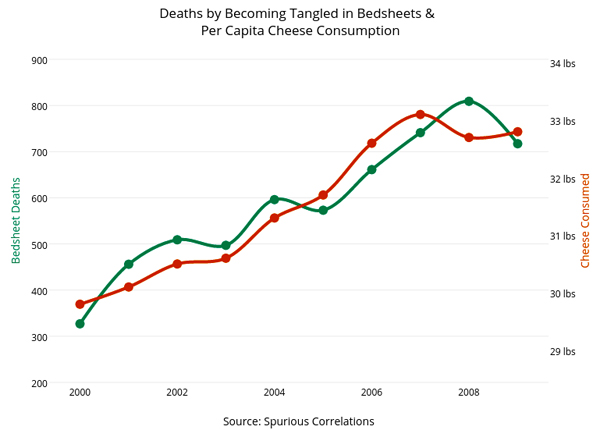
Éliminons d’abord le cas des corrélations par hasard, d’aucune utilité, si ce n’est comme source d’escroquerie. Le mécanisme est simple. Chaque année, des milliards d’évènements se produisent et grâce aux Big Data (voir Tangente 181) on dispose aujourd’hui de la trace écrite de l’évolution de plusieurs millions d’entre eux. C’est bien le diable si, en en choisissant une, on ne trouve pas, parmi les millions restantes, une autre qui lui ressemble ! Surtout si l’on peut manipuler les échelles de la représentation… En effet, en modifiant l’échelle des ordonnées, on peut établir à sa guise la pente moyenne des courbes. Le site Spurious Correlations (tylervigen.com/spurious-correlations) en donne bien des exemples farfelus mais spectaculaires.
À l’autre extrémité, il y a les corrélations causales : toujours, si vous courez un cent mètres, votre rythme cardiaque s’accélère.