La forza del ragionamento matematico si rivela talvolta fonte di solido conforto, anche negli ambiti più inattesi. Di fronte ai danni del Covid-19, in tempi difficili e incerti, una rappresentazione razionale, fondata su ipotesi realistiche, offre risposte argomentate ad alcune delle domande che ciascuno si pone. Anche se nessuno può cogliere tutte le conseguenze sociali ed economiche della pandemia che imperversa in questo momento, il ricorso alla modellizzazione del fenomeno si rivela di notevole utilità, spiegando o giustificando alcune misure adottate, come il confinamento o la quarantena. Certo, il ricorso alla modellizzazione, e dunque a una forma di semplificazione, passa sempre attraverso una serie di ipotesi semplificatrici la cui validità non è necessariamente scontata. Occorre tenerne conto al momento di trarre le conclusioni e nella fase decisionale. Ciò è ancora più vero per un fenomeno epidemiologico come il Covid-19, per il quale dati affidabili o completi sono ancora oggi praticamente indisponibili.
Il modello SIR
-------------
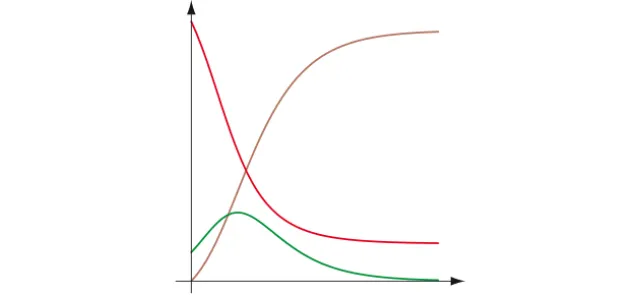
A oggi sono stati sviluppati diversi modelli epidemiologici. I più elementari sono i modelli compartimentali, che offrono già una prospettiva particolarmente interessante su alcuni aspetti del fenomeno pandemico che stiamo vivendo. Il modello SIR appartiene a questa categoria.
Sia P una popolazione di n individui, con n «grande». In un primo momento, supponiamo che in P non vi sia alcuna immunità iniziale. È proprio il caso del Covid-19: al momento della sua comparsa non era disponibile alcun vaccino e i sistemi immunitari delle persone coinvolte, mai esposti al nuovo virus, non erano ancora in grado di reagire. Supponiamo inoltre che tutti gli individui siano «simili». Questa ipotesi non è ovviamente verificata nella pratica ma, poiché il ragionamento riguarda una popolazione ampia, un approccio basato sui valori medi può quindi essere interessante.
Dividiamo la popolazione in tre gruppi. Da una parte vi sono le persone sane, S (come «susceptible»), dall’altra le persone infette, I (come «infectious»). Infine, vi è il gruppo delle persone guarite, R (come «recovered»). Il tutto dà origine all’acronimo SIR.
La compartimentazione può ovviamente essere più articolata. Si può infatti aggiungere una categoria dei deceduti, D (come «dead»), e un gruppo di persone infette poste in quarantena, Q, che per questo non contribuiscono più al contagio della popolazione sana. In un primo momento, si tratta soprattutto di visualizzare l’evoluzione delle infezioni quando non viene adottata alcuna misura e si lascia che il virus si diffonda liberamente.
I modelli SIR possono essere discreti o continui. In un quadro discreto, si rilevano, a ogni unità di tempo (giorni o settimane), le numerosità dei diversi compartimenti. All’istante 0, si suppone nota la ripartizione della popolazione, con S di cardinalità n − 1, I contenente 1 individuo e R vuoto. Si suppone allora che, a ogni intervallo di tempo, ogni individuo infetto possa contagiare ciascuna persona del compartimento S con una certa probabilità p. Dopo ogni unità di tempo, un individuo infetto guarisce (o muore) e passa dunque da I a R (o a D). Il modello è quindi stocastico e può potenzialmente condurre a un gran numero di scenari. Per descrivere l’evoluzione dei compartimenti, l’Istituto internazionale di statistica (ISI, organizzazione fondata nel 1885 e indipendente da ogni governo) ha diffuso presso tutti i suoi membri un eccellente studio sull’argomento realizzato dal professore Tom Britton (Università di Stoccolma) e disponibile online. Questo statistico ha condotto simulazioni su larga scala, prendendo in considerazione diversi valori della coppia (n, p). Uno dei parametri del modello si rivelerà fondamentale per le conclusioni che se ne traggono: è il tasso di riproduzione di base, ossia il numero di persone di P che ciascun malato può infettare. Britton stima inizialmente questo parametro mediante la relazione approssimata R 0 ≈ (n − 1) p ≈ np, agendo da un lato sulla dimensione di P e dall’altro sulla piccolezza di p.
Il matematico Tom Britton.
Si presentano due casi principali. Quando R 0 è minore o uguale a 1, non si sviluppa alcuna epidemia. La percentuale di persone contagiate non supera mai il 10%. Quando invece il tasso di riproduzione di base R 0 supera 1, compaiono due scenari. O il virus scompare rapidamente, contagiando un piccolo numero di individui (meno del 10%), oppure si osserva una percentuale critica di contagiati. Così, per R 0 = 1,5, in un gran numero di simulazioni si osserva un tasso di contagio vicino al 60%. Valori intermedi, tra il 10 e il 50% di contagi, non si osservano invece mai. Questo fenomeno può essere spiegato. Indichiamo infatti con τ il tasso finale di persone infettate dalla pandemia. Il numero totale di individui passati per la categoria I è dunque uguale a nτ. La proporzione della popolazione non infettata dal virus è ovviamente 1 − τ. Nel quadro del modello, questa quantità può essere vista come una probabilità, precisamente la probabilità di non essere stati infettati dagli nτ individui a loro volta portatori del virus per tutta la durata dell’epidemia. Se i contagi sono eventi indipendenti, possiamo scrivere 1 − τ = (1 − p) *n*τ.
Resta da sostituire p con il suo valore dedotto dal tasso di riproduzione di base stimato, ossia p = R 0 / n. Otteniamo quindi la relazione che ammette un limite ben noto quando n tende all’infinito, exp (− R 0τ).
La stima di R0
-----------------------------
L’equazione da risolvere è dunque 1 − τ − exp(−R 0τ) = 0. Indichiamo con f (τ) il membro sinistro. L’equazione ammette sempre la soluzione banale τ = 0. È peraltro l’unica soluzione per ogni valore di R 0 minore o uguale a 1. Per valori di R 0 strettamente maggiori di 1, invece, compare una seconda soluzione positiva, come si vede nel grafico seguente, che rappresenta la funzione f (τ) corrispondente al valore R 0 = 1,5.
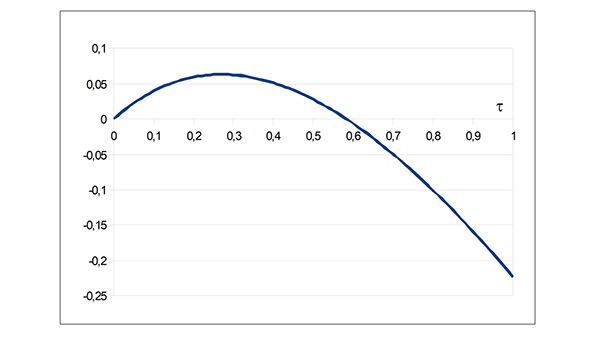
Rappresentazione della funzione f per R0 = 1,5.
La seconda soluzione (τ ≈ 58%) concorda perfettamente con i risultati osservati nella simulazione. Non esiste una forma esplicita della soluzione generale, ma i calcoli numerici si eseguono facilmente e forniscono il grafico seguente, che stima il tasso di contagio τ della popolazione in funzione del tasso di riproduzione di base R 0. La crescita è «rapida» non appena R 0 si allontana dal valore soglia 1. Nel caso del Covid-19, diverse fonti stimano il valore del parametro R 0 tra 2 e 2,5: senza una reazione della popolazione né l’adozione di misure preventive, ciò lascia prevedere un tasso di contagio dell’ordine dell’80%.
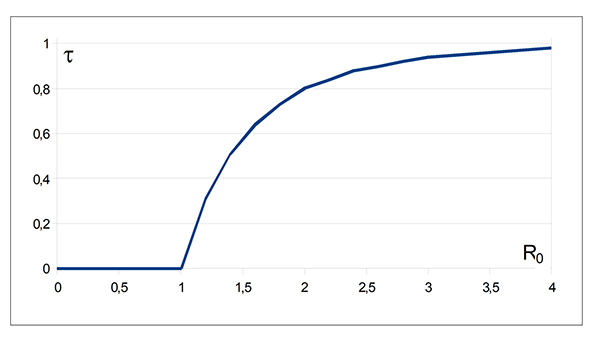
Stima di τ in funzione di R0.
L’effetto delle misure
-------------------
La situazione è ovviamente del tutto diversa non appena la popolazione colpita comprende una parte di individui immuni o vaccinati. Supponiamo dunque che una proporzione q della popolazione sia immunizzata o vaccinata. Solo la proporzione 1 − q della popolazione potrà essere soggetta al contagio e sarà esposta al contagio da parte degli individui malati. La nostra equazione diventa ora 1 − τ = q + (1 − q) exp(− R 0τ).
Immaginiamo ora che metà della popolazione sia vaccinata (q = 1/2). L’unica soluzione della nuova equazione, per valori di R 0 minori o uguali a 2, è allora τ = 0. Il modello conferma quantitativamente che una vaccinazione di massa è la soluzione per evitare il ritorno del virus e una seconda pandemia. Il grafico seguente confronta le situazioni senza vaccinazione (in blu) e con vaccinazione (in rosso) per q = 0,5.
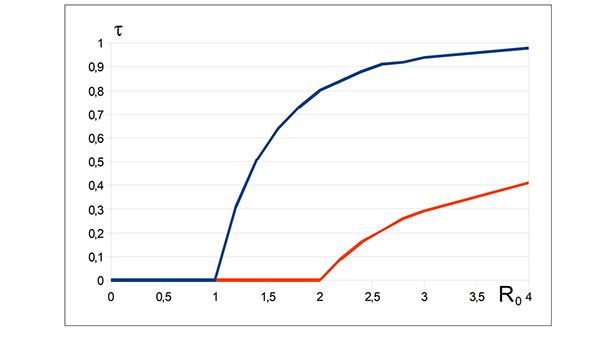
Evoluzione di τ in funzione di R0, con (in rosso) e senza (in blu)
vaccinazione di massa della popolazione.
Non siamo ancora a questo punto. E allora? Che cosa fare per combattere ciò che a prima vista sembra inevitabile? Sembra realistico supporre che il tasso di riproduzione di base debba essere proporzionale alla probabilità di trasmissione per contatto. È il caso del precedente modello SIR: R 0 = np. Possiamo agire su questa probabilità indossando mascherine, lavandoci le mani: tutte azioni che avranno effetto sul fattore p.
Ma il tasso di riproduzione dipende altrettanto evidentemente dal numero di contatti di ciascun individuo con ogni altro individuo. Possiamo dunque agire una seconda volta sul parametro R0, confinando a casa gran parte della popolazione e vietando riunioni e assembramenti pubblici.
Intervengono anche altri fattori, come il tasso di screening nella popolazione. Nel caso del Covid-19, alcuni Paesi effettuano screening di massa, come la Germania. Altri, come il Belgio, nelle prime settimane hanno sottoposto a test soltanto i pazienti in condizioni preoccupanti e con i sintomi della malattia, oppure il personale sanitario… purché avesse la febbre! La dimensione delle popolazioni S e I è dunque sconosciuta. È quindi impossibile determinare un tasso di mortalità credibile. Il compartimento R comprende dunque sia le persone guarite sia quelle decedute. Statistiche successive permetteranno probabilmente di quantificare correttamente il tasso di mortalità. Si coglie qui l’interesse di iniziative come il progetto Polymath.
Che cosa dobbiamo trarre da tutto ciò? Anzitutto, che si possono adottare misure adeguate e che queste devono agire sul tasso di riproduzione di base. Qui sta l’interesse dei modelli matematici: quantificano le conseguenze delle nostre azioni. In quanto strumenti di supporto decisionale, giustificano alcune misure difficili. Infine, ci rassicurano sul futuro. Che cosa chiedere di più?