Come misurare la somiglianza tra testi? Bisognerebbe, per esempio, poter definire distanze tra questi oggetti. Un modo per farlo consiste nel rappresentare un testo con un vettore, quindi nel definire una «funzione di similarità», oppure una distanza, che permetta di confrontare tali vettori.
Si può, per esempio, indicare la presenza o l’assenza di una parola (di un vocabolo). Un testo è allora rappresentato da un vettore le cui componenti valgono 0 oppure 1. Il numero n di componenti del vettore (la dimensione dello spazio vettoriale) è il numero di vocaboli considerati, ossia la dimensione del vocabolario. Numerando ogni vocabolo da 1 a n, un testo X è allora rappresentato da un vettore (*xi)i*=1…*n in cui xi = 1 se il vocabolo i compare nel testo, e xi = 0 altrimenti. Questa rappresentazione vettoriale è generalmente usata per calcolare la proporzione di vocabolario comune tra i testi. È l’indice di Jaccard*, definibile come segue:
con X = (*xi)i*=1…*n e Y = (yi)i*=1…*n due testi di n* parole.
Prendiamo due esempi. Il testo S è: «Il Sole dice: “Sono il Sole.”» Il testo L è il seguente: «“Sono il Sole”, dice la Luna.» Allora n = 7 e Sim(S, L) = (11 + 11 + 01 + 11 + 01 + 11 + 11) / 7 = 5/7.
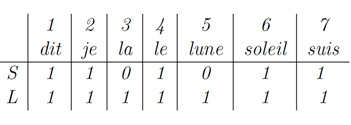
Conteggio dei vocaboli presenti nell’insieme dei due testi, ordinati alfabeticamente.
Non conta la dimensione…
----------------------------------
L’indice di similarità vale dunque 1 se nei due testi è usato esattamente lo stesso vocabolario, e 0 se i due testi non hanno alcuna parola in comune. Ciò può accadere quando si confrontano testi scritti in lingue diverse.
Possiamo affinare questo indice sostituendo l’informazione di presenza/assenza di un vocabolo M con il numero di occorrenze di M nel testo. In questo caso, ogni componente del vettore indica il numero di occorrenze di M. Con questo tipo di rappresentazione vettoriale si potrebbe usare una classica distanza euclidea:
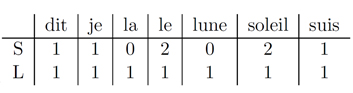
Numero di occorrenze di ciascun vocabolo.
Nel nostro esempio,
Ma, in pratica, il numero assoluto di occorrenze dipende molto dalla dimensione dei testi. Più il testo è lungo, maggiori sono i valori delle componenti. Per questo si preferisce usare come misura di similarità il coseno dell’angolo θ fra i due vettori:
\text{SimCos(X, Y)} = \text{\cos} \; \theta = \dfrac { \sum_{i=1}^{n} {x_i}{y_i}} { \sqrt{\sum_{i=1}^{n} x_i ^2} \sqrt{\sum_{i=1}^{n} y_i ^2}}
Poiché le componenti dei vettori sono sempre positive, la misura di similarità varia fra 0 e 1. Vale 1 quando l’angolo fra i vettori è 0, cioè quando i due vettori sono identici (stesso numero di occorrenze per tutti i vocaboli) o collineari (numeri di occorrenze proporzionali). La similarità vale 0 quando i due vettori sono ortogonali, cioè quando non condividono alcun vocabolo.
Nel nostro esempio,
ossia circa 0,8.
Per tenere conto della dimensione dei testi, espressa in numero di parole, si possono anche sostituire i numeri di occorrenze con la frequenza relativa di comparsa di ciascun vocabolo. Una componente del vettore può allora essere interpretata come la probabilità di incontrare un dato vocabolo nel testo.
Un testo è ora rappresentato da un vettore (*xi)i*=1…N dove *xi = ni / T, essendo ni il numero di volte in cui il vocabolo i compare nel testo e T la dimensione del testo, in numero di parole. Con questo tipo di rappresentazione si può usare una distanza, detta intertestuale*, di tipo L1:
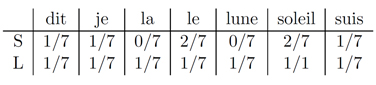
I testi S e L rappresentati da un vettore di frequenze.
La distanza intertestuale può essere interpretata in modo abbastanza naturale come un numero medio di parole diverse ogni cento parole, oppure come la proporzione di vocaboli da «cambiare» per passare da un testo all’altro. Così, δ(S, L) = (1/2)(4/7) = 2/7 e, cambiando due parole su sette, si può «passare» da un testo all’altro, prescindendo dall’ordine delle parole.
-
Un po’ d’ordine…
---------------
Gli approcci precedenti non tengono conto dell’ordine delle parole. Inoltre, in S e L, se il Sole è il sole, si può ragionevolmente pensare che la luna lo segua, dal verbo «seguire». In alcune applicazioni è indispensabile evitare di confondere «suis» (essere) con «suis» (seguire), «été» (essere) con la stagione, oppure «est» (essere) con la direzione orientale. È quindi spesso necessario lavorare su testi in cui ogni parola è etichettata con la sua forma canonica, ossia la voce di dizionario, e con la sua categoria grammaticale.
In pratica, questo tipo di rappresentazione vettoriale è molto usato nel recupero dell’informazione, per esempio per trovare testi simili a un testo iniziale usato come interrogazione. Una semplice interrogazione può consistere in poche parole chiave. Un motore di ricerca documentale, grazie alla rappresentazione vettoriale e al calcolo di similarità, può ordinare i documenti restituiti dal più pertinente, cioè il più simile alla serie di parole chiave, al meno pertinente. Anche i motori di ricerca (Google, Yahoo, Bing…) possono usare questo tipo di rappresentazioni per confrontare le pagine web corrispondenti a un’interrogazione ed eliminare i duplicati dall’elenco dei risultati forniti all’utente.
In letteratura, la distanza intertestuale è usata anche per studiare ciò che avvicina o allontana generi diversi, come il romanzo, il teatro, il francese parlato vs scritto, la poesia o il genere epistolare, oppure per discutere la paternità di un’opera, come Romain Gary vs Émile Ajar, Molière vs Corneille. Con tutte le polemiche che questi studi possono suscitare…