¿Cómo medir la semejanza entre textos? Habría que poder definir, por ejemplo, distancias entre estos objetos. Una forma de proceder consiste en representar un texto mediante un vector y definir después una «función de similitud», o una distancia, que permita comparar esos vectores.
Por ejemplo, puede indicarse la presencia o ausencia de una palabra (un vocablo). Un texto queda entonces representado por un vector cuyas componentes valen 0 o 1. El número n de componentes del vector —la dimensión del espacio vectorial— es el número de vocablos considerados, es decir, el tamaño del vocabulario. Al numerar cada vocablo del 1 al n, un texto X queda representado por un vector (*xi)i*=1…*n donde xi = 1 si el vocablo i aparece en el texto, y xi = 0 en caso contrario. Esta representación vectorial se utiliza en general para calcular la proporción de vocabulario común entre los textos. Es el índice de Jaccard*, que puede definirse como:
donde X = (*xi)i*=1…*n e Y = (yi)i*=1…*n son dos textos de n* palabras.
Tomemos dos ejemplos. El texto S es: «El Sol dice: “Yo soy el Sol.”» El texto L es el siguiente: «“Yo soy el Sol”, dice la Luna.» Entonces n = 7 y Sim(S, L) = (11 + 11 + 01 + 11 + 01 + 11 + 11) / 7 = 5/7.
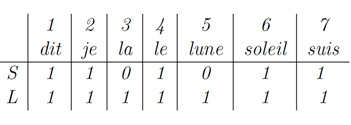
Recuento de los vocablos presentes en el conjunto de ambos textos, ordenados alfabéticamente.
No importa el tamaño…
----------------------------------
Así, el índice de similitud vale 1 si se utiliza exactamente el mismo vocabulario en ambos textos, y 0 si los dos textos no tienen ninguna palabra en común. Esto puede ocurrir al comparar dos textos redactados en lenguas diferentes.
Este índice puede refinarse sustituyendo la información de presencia o ausencia de un vocablo M por el número de apariciones de M en el texto. En ese caso, cada componente del vector indica el número de apariciones de M. Con este tipo de representación vectorial podría utilizarse una distancia euclidiana clásica:
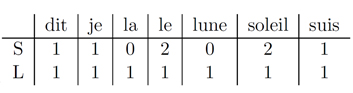
Número de apariciones de cada vocablo.
En nuestro ejemplo,
Pero, en la práctica, el número absoluto de apariciones depende mucho de la longitud de los textos. Cuanto más largo es el texto, mayores son los valores de las componentes. Por ello, se prefiere usar como medida de similitud el coseno del ángulo θ entre los dos vectores:
\text{SimCos(X, Y)} = \text{\cos} \; \theta = \dfrac { \sum_{i=1}^{n} {x_i}{y_i}} { \sqrt{\sum_{i=1}^{n} x_i ^2} \sqrt{\sum_{i=1}^{n} y_i ^2}}
Como las componentes de los vectores siempre son positivas, la medida de similitud varía entre 0 y 1. Vale 1 cuando el ángulo entre los vectores es 0, es decir, cuando los dos vectores son idénticos —mismo número de apariciones de todos los vocablos— o colineales —números de apariciones múltiplos entre sí—. La similitud vale 0 cuando los dos vectores son ortogonales, es decir, cuando no comparten ningún vocablo.
En nuestro ejemplo,
es decir, aproximadamente 0,8.
Para tener en cuenta la longitud de los textos —en número de palabras—, también pueden sustituirse los números de apariciones por la frecuencia relativa de aparición de cada vocablo. Entonces, una componente del vector puede interpretarse como la probabilidad de encontrar un vocablo dado en el texto.
Ahora un texto queda representado por un vector (*xi)i*=1…N donde *xi = ni / T, ni es el número de veces que el vocablo i aparece en el texto y T es la longitud del texto —en número de palabras—. Con este tipo de representación puede utilizarse una distancia —llamada intertextual*— de tipo L1:
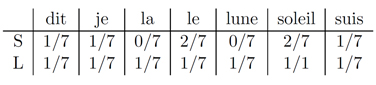
Los textos S y L representados mediante un vector de frecuencias.
La distancia intertextual puede interpretarse de manera bastante natural como un número medio de palabras diferentes por cada cien palabras, o como la proporción de vocablos que hay que «cambiar» para pasar de un texto a otro. Así, δ(S, L) = (1/2)(4/7) = 2/7, y cambiando dos palabras de cada siete se puede «pasar» de un texto a otro, sin tener en cuenta el orden de las palabras.
-
Un poco de orden…
---------------
Los enfoques anteriores no tienen en cuenta el orden de las palabras. Además, en S y L, si el Sol es el sol, cabe pensar razonablemente que la luna lo sigue (del verbo «seguir»). En algunas aplicaciones, es indispensable evitar confundir «suis» (ser) con «suis» (seguir), «été» (ser) con la estación, o «est» (ser) con la dirección oriental. Por ello, a menudo es necesario trabajar con textos en los que cada palabra está etiquetada con su forma canónica (entrada del diccionario) y su categoría gramatical.
En la práctica, este tipo de representación vectorial se utiliza mucho en recuperación de información, por ejemplo, para recuperar textos similares a un texto inicial utilizado como consulta. Una forma trivial de texto de consulta puede consistir en unas pocas palabras clave. Gracias a la representación vectorial y a un cálculo de similitud, un motor de búsqueda documental puede ordenar los documentos resultantes del más pertinente —el más similar a esas palabras clave— al menos pertinente. Los motores de búsqueda —Google, Yahoo, Bing…— también pueden utilizar este tipo de representaciones para comparar las páginas web que responden a una consulta y eliminar los duplicados de la lista de respuestas proporcionada al usuario.
En literatura, la distancia intertextual también se utiliza para estudiar lo que acerca o aleja los distintos géneros —novela, teatro, francés hablado frente a escrito, poesía, género epistolar…— o para debatir la autoría de una obra —Romain Gary frente a Émile Ajar, Molière frente a Corneille—. Con todas las polémicas que estos trabajos pueden suscitar…