Imagine que dispone de una gran tabla de datos: en las filas, individuos (u observaciones); en las columnas, variables que los caracterizan. La tabla es grande y contiene muchas filas. También podría contener muchas columnas, pero eso no nos preocupa de momento. Y no tiene ningún conocimiento a priori sobre la estructura de las observaciones.
Grupos de puntos
---------------------
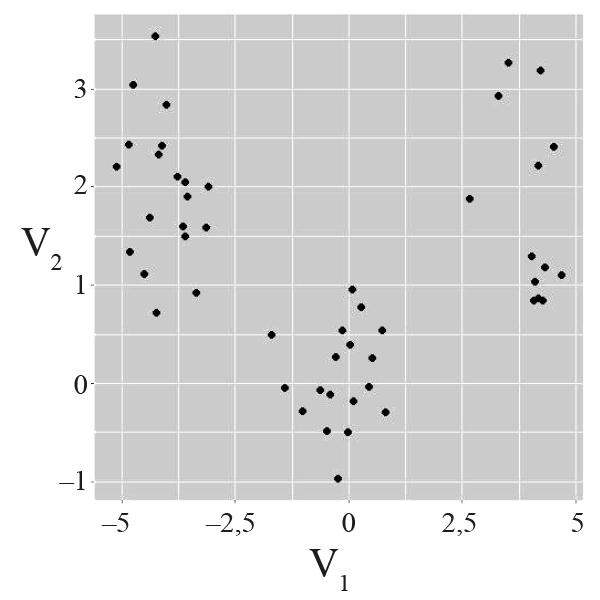
Para llevarlo al extremo, y porque es más fácil de visualizar, supongamos que solo contiene dos columnas, correspondientes a dos variables cuantitativas (que se miden), denominadas V1 y V2. Por tanto, una observación representa un punto de ℝ2. Para comprender bien estos datos, podemos resumir cada una de las variables (media, desviación típica) y representarlas en una figura, con V1 en el eje de abscisas y V2 en el de ordenadas.
Del ejemplo superior se desprende una información muy interesante —en él vemos tres grupos muy diferenciados—, mientras que en el inferior todo parece formar un único conglomerado. El ejemplo central es intermedio: podrían definirse tres grupos, pero las fronteras no están claras.